

Cómo optimizamos nuestra propia web para la búsqueda con IA: un caso de éxito de GEO
 Por Sergii Anufriiev, Fundador y CEO — 05 oct 2026
Cuando le pedimos a ChatGPT que recomendara una agencia para migrar a Shopify, nombró primero a URich, tanto en inglés como en ucraniano. En los 90 días anteriores, Google nos había enviado exactamente 2 clics desde búsquedas sin marca. Esos dos hechos conviven en nuestros propios datos y juntos explican por qué dejamos de tratar la búsqueda con IA como «SEO con otro nombre».
Esta es la Parte 1 de nuestro propio caso de éxito de GEO: la línea base, lo que auditamos, lo que cambiamos y las primeras señales. Añadiremos los resultados a este artículo cuando haya datos suficientes para comparar.
CONCLUSIONES CLAVE
- Las visitas desde la IA y las posiciones en Google son métricas distintas. 14 sesiones llegaron desde ChatGPT en 30 días, mientras que 11 548 impresiones de Google sin marca produjeron 2 clics.
- Los asistentes de IA citan hechos, no eslóganes. Reescribimos las introducciones de nuestras páginas de servicio como definiciones y dimos a cada caso de éxito un resumen de una línea, respaldado por una métrica, en
llms.txt. - Las respuestas de la IA reutilizan tus propias palabras. ChatGPT describe ahora nuestro servicio de migración casi exactamente como lo hacen nuestras propias páginas.
- Mide lo que puedas y di lo que no puedes medir. Los clics de referencia son el suelo de la visibilidad en IA, no el techo.
POR QUÉ NOS HICIMOS ESTO A NOSOTROS MISMOS
Vendemos AI Search & Agent Readiness (GEO) como servicio: auditamos y corregimos cómo ven ChatGPT, Perplexity y AI Overviews los sitios de eCommerce. Así que, cuando nuestras analíticas mostraron tráfico real y espontáneo que ya llegaba desde ChatGPT, tuvimos dos opciones: escribir otro artículo genérico sobre «qué es GEO» o auditarnos a nosotros mismos y publicar exactamente lo que encontráramos, con las cifras incluidas. Elegimos la segunda.
CÓMO DECIDEN LOS ASISTENTES DE IA QUÉ CITAR
Conviene saber para qué estás optimizando. Un asistente de IA puede conocer tu marca de dos maneras:
- A través de sus datos de entrenamiento – una instantánea de la web tomada meses antes de que preguntes. No puedes editarla a posteriori.
- A través de la recuperación en vivo – cuando ChatGPT search, Perplexity o Google AI Overviews buscan información en el momento de la pregunta, sus rastreadores (OAI-SearchBot y ChatGPT-User, PerplexityBot, Googlebot) descargan páginas, el modelo las resume y enlaza las fuentes.
La recuperación en vivo es la parte sobre la que una web puede influir. Para que te citen, una página tiene que ser accesible para el rastreador, fácil de interpretar y contener una frase que el modelo pueda tomar como un hecho: una definición, una cifra, un «para quién es» claro. Los datos de la marca también deben coincidir en toda la web: si tu sitio, tu perfil de Clutch y tu página de LinkedIn te describen de forma distinta, el modelo tiene menos motivos para fiarse de cualquiera de ellos.
Una nota honesta sobre llms.txt: es una propuesta de 2024 para crear un mapa en texto plano de un sitio, escrito para modelos de lenguaje. Ningún proveedor de IA importante ha confirmado que lea el archivo, y representantes de Google le han restado importancia públicamente. Lo tratamos como un seguro barato y como una buena excusa para redactar resúmenes claros, no como un factor de posicionamiento.
PASO 1: ENCONTRAR LA SEÑAL EN LOS DATOS
GA4 ya agrupa el tráfico en un canal de «AI Assistant»; la mayoría de los equipos nunca lo mira porque es pequeño. En los últimos 30 días fueron 14 sesiones, el 100% de ellas referidas desde chatgpt.com: una persona real le hizo una pregunta a ChatGPT, ChatGPT respondió con un enlace a nuestra web y esa persona hizo clic.
Las páginas de destino nos mostraron dónde ChatGPT ya nos consideraba dignos de cita: sobre todo casos de éxito (/cases/aurora-crystal/, /cases/janado/, /cases/) y un puñado de páginas de servicio (headless commerce, soluciones de IA, desarrollo en Shopify).
Dos cosas nos sorprendieron. Primero, ChatGPT ya enviaba personas a nuestras páginas en ucraniano – /uk/services/headless-e-commerce/ y /uk/services/shopify-development/ – a las pocas semanas de publicar la versión ucraniana. Una segunda versión de idioma es una segunda oportunidad de coincidir con cómo la gente formula realmente su pregunta. Segundo, la tendencia iba a la baja: 14, luego 13 y luego 10 sesiones en la ventana de los últimos 30 días. Si no se hace nada, la visibilidad en IA no crece por sí sola.
PASO 2: POR QUÉ ESTA MÉTRICA NO ES LA MISMA QUE LA DEL SEO
Antes de cambiar nada, extrajimos 90 días de datos de Search Console como línea base. Las consultas de marca (búsquedas que contienen «urich») tuvieron 1 892 impresiones y 36 clics, un patrón normal de búsqueda de marca. Las consultas sin marca tuvieron 11 548 impresiones y solo 2 clics, una tasa de clics del 0,02%.
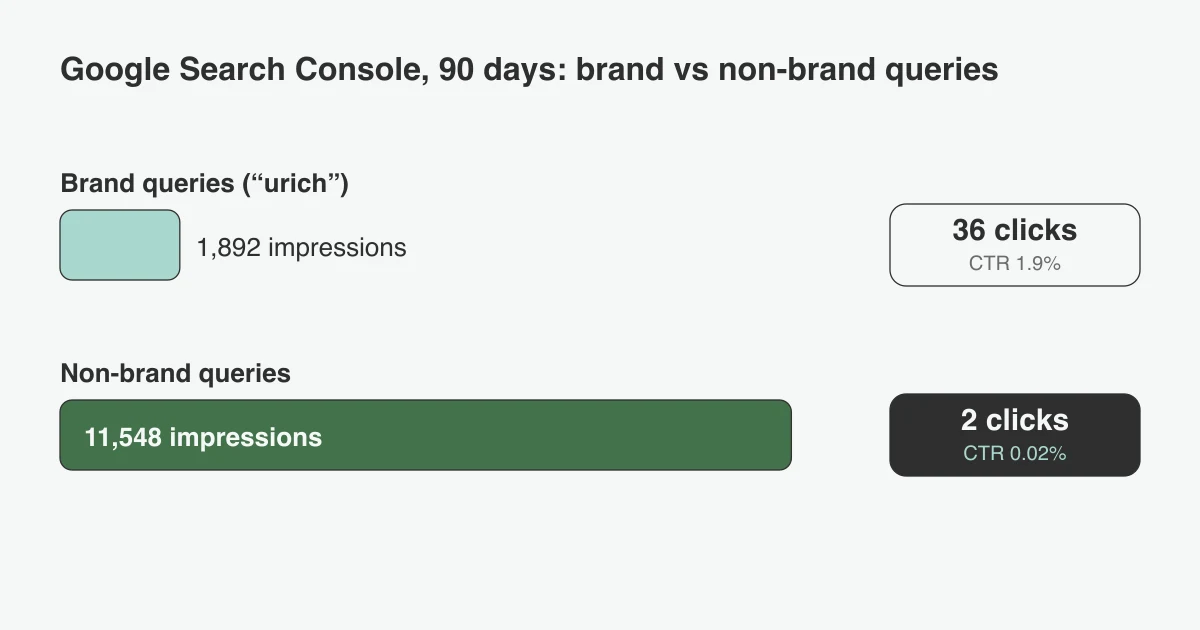
En pocas palabras: Google muestra nuestras páginas para muchas consultas de cola larga, pero casi nadie hace clic, lo que suele indicar posiciones medias bajas en esos términos. Y aun así, ChatGPT nos enviaba clics reales en el mismo periodo. El GEO y el SEO clásico son disciplinas cercanas, pero no la misma: una página puede ser prácticamente invisible entre los primeros resultados de Google y aun así ser citada por un asistente de IA que la leyó directamente.
El SEO clásico tampoco se queda quieto: en la última ventana de 28 días, «woocommerce to shopify migration» alcanzó 588 impresiones con una posición media de 18,9. Hacemos seguimiento de ambos, por separado.
UN HALLAZGO INESPERADO: HUELLAS DE IA EN SEARCH CONSOLE
Al revisar consultas de cola larga, encontramos búsquedas que ninguna persona escribiría. Una decía: «agent monetization, commercial, mofu, primary, ai/product teams, hero h1 directly references this concept», un fragmento de lo que parece un brief de contenido. Otra: «accuracy of ai seo geo platforms tracking position in ai shopping guides».
Nuestra hipótesis de trabajo: las herramientas de IA (agentes de investigación, plataformas de SEO, asistentes con búsqueda web) lanzan búsquedas en Google en nombre de alguien y sus prompts a veces se filtran en la consulta. No podemos demostrar quién las envió, así que trátalo como una observación, no como un hecho. Pero es un buen recordatorio de que parte de tu «audiencia de búsqueda» ya es software, y lee tus páginas igual que lo hace un modelo.
PASO 3: AUDITAR LO QUE YA TENÍAMOS BIEN
Antes de añadir nada, comprobamos qué había ya en marcha:
- llms.txt ya existía en
/llms.txt: un índice en texto plano de nuestros servicios, casos de éxito y datos de la empresa, escrito para sistemas de IA y no para rastreadores de búsqueda. robots.txtya permitía de forma explícita GPTBot, ChatGPT-User, OAI-SearchBot, PerplexityBot, ClaudeBot, Claude-User, Google-Extended, Applebot-Extended, Amazonbot y ocho rastreadores de IA más con nombre propio, no solo la regla comodín por defecto.- Los datos estructurados (JSON-LD) ya cubrían los esquemas Organization, WebSite, BreadcrumbList y Article en todo el sitio, con esquema FAQPage en 82 de las 131 páginas indexadas.
Es una base sólida: la mayoría de los sitios no tiene nada de esto. Pero al revisar los datos en lugar de suponer, destacaron dos carencias concretas: llms.txt incluía solo 3 de nuestros 28 casos de éxito publicados, y la mayoría de las páginas de servicio empezaban con texto de marketing («libera una flexibilidad ilimitada…») en lugar de una definición que un sistema de IA pudiera tomar y citar como un hecho.
PASO 4: CERRAR LA BRECHA DE LOS CASOS DE ÉXITO
Dos de los casos de éxito que ya generaban tráfico de referencia desde ChatGPT, Aurora Crystal y Janado, ni siquiera estaban en llms.txt. Ampliamos el archivo para cubrir los 28 casos publicados, una línea por cada uno, y cada línea incluye una métrica real ya publicada en lugar de una descripción genérica:
[Aurora Crystal](https://urich.org/cases/aurora-crystal/): tema personalizado de Shopify para una marca de joyería de lujo, +26% de conversiones en móvil.[Janado](https://urich.org/cases/janado/): marketplace de eCommerce escalable, +38% de tasa de conversión.
La lógica: un sistema de IA que responde a «quién creó una tienda Shopify para una marca de lujo» o «agencia de eCommerce con un caso de éxito en fintech» necesita un hecho concreto y citable con el que trabajar, no un párrafo de adjetivos.
PASO 5: REESCRIBIR LAS PÁGINAS DE SERVICIO COMO DEFINICIONES, NO COMO DISCURSOS DE VENTA
El texto de marketing y el texto citable se leen de forma distinta. Nuestra página de headless commerce solía empezar así:
«Desarrollo de E-COMMERCE headless para un comercio de alto rendimiento y preparado para el futuro. Libera una flexibilidad, una escalabilidad y una velocidad ilimitadas con el eCommerce headless.»
Está bien como discurso de venta, pero un sistema de IA no puede tomar «libera una flexibilidad ilimitada» como un hecho sobre lo que es realmente el headless commerce. Lo reescribimos primero como definición y después como posicionamiento:
«El headless commerce separa el escaparate de la tienda (frontend) de la plataforma de backend y los conecta mediante API en lugar de un único sistema monolítico. URich crea escaparates headless con Next.js/React conectados a Shopify, BigCommerce, Commerce Layer o un backend totalmente a medida, normalmente para marcas D2C que necesitan tiempos de carga inferiores al segundo, control total del diseño o escalado multirregión y multidivisa más allá de lo que admite el tema de una plataforma estándar.»
Aplicamos el mismo tratamiento a las introducciones de nuestras principales páginas de servicio.
Una prueba sencilla que usamos ahora en cada introducción: ¿podría esta frase aparecer, sin cambios, en una respuesta a «qué es X y quién lo hace»? Si solo tiene sentido como anuncio, no la citarán.
PASO 6: FAQ DONDE YA ESTABA EL TRÁFICO, NO EN TODAS PARTES A LA VEZ
Añadimos una sección de FAQ visible (junto con el esquema FAQPage correspondiente) a Aurora Crystal, Janado y Oroy, concretamente los tres casos de éxito que GA4 mostraba que ya recibían clics de referencia desde la IA, en lugar de a los 28 a la vez. Cada FAQ responde a una pregunta basada en los datos publicados del propio proyecto (por ejemplo, «¿Por qué bajó un 34% el abandono del checkout?»), no en texto genérico de relleno. Priorizar según la evidencia nos permitió publicar, verificar y medir antes de comprometernos con los 25 restantes.
PASO 7: MEDIR LO QUE NO PUEDES VER POR COMPLETO
Configuramos un informe semanal fijo (GA4 + Search Console) con una sección específica de «visitas de referencia desde asistentes de IA»: qué páginas de destino, qué fuentes de IA y la tendencia a lo largo del tiempo. Es un indicador imperfecto: un chatbot puede leer nuestro contenido y responder con él sin que nadie haga clic, y ninguna herramienta de analítica lo muestra. Un clic de referencia es el suelo de la visibilidad en IA, no el techo, pero es la parte que realmente podemos medir hoy, así que es la que seguimos.
PRIMERA SEÑAL: LO QUE CHATGPT DICE DE NOSOTROS AHORA
Cuando los cambios ya estaban en vivo, le hicimos a ChatGPT la pregunta que haría un cliente potencial. La hicimos desde nuestra propia cuenta, así que la respuesta puede estar personalizada: tómala como una señal, no como una prueba.
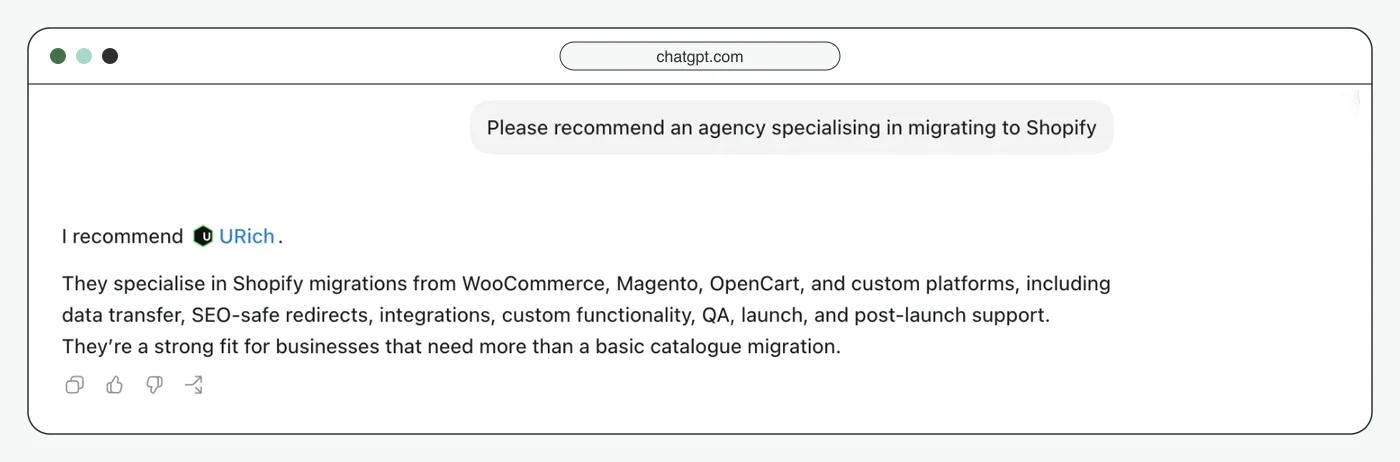
Lo que leemos en esta respuesta:
- Repite nuestras propias palabras. «WooCommerce, Magento, OpenCart y plataformas a medida… redirecciones seguras para el SEO… soporte posterior al lanzamiento» se parece mucho a cómo describen ahora el servicio nuestras páginas de migración.
- Explica para quién somos. «Una buena opción para empresas que necesitan algo más que una migración básica de catálogo»: posicionamiento, no solo una lista de servicios.
- Nombra a una sola agencia, no una lista. La respuesta recomienda solo a URich, sin una preselección de alternativas.
No podemos atribuir esta respuesta a un único cambio; puede basarse también en datos más antiguos. Precisamente por eso, la Parte 2 comparará cifras, no capturas de pantalla.
LO QUE AÚN NO SABEMOS
- Las cifras son pequeñas. De 10 a 14 sesiones al mes pueden variar según la semana de una sola persona. Miramos tendencias de meses, no de días.
- Las respuestas varían. La misma pregunta puede recibir mañana una respuesta distinta, desde otra cuenta o en otro país.
- Las citas sin clic son invisibles. Si ChatGPT nos recomienda y el usuario recuerda el nombre en lugar de hacer clic, la analítica no muestra nada; como mucho, una búsqueda de marca posterior.
- La atribución es difusa. llms.txt, las introducciones reescritas, las FAQ y nuestras reseñas en plataformas de terceros cambiaron o existieron al mismo tiempo. No podemos aislar cuál importa más.
CÓMO SE APLICA ESTO A UNA TIENDA ONLINE
Nuestra web vende servicios, así que los casos de éxito y las páginas de servicio eran los activos que importaban. En una tienda eCommerce, los mismos principios se aplican a otras páginas:
- Páginas de producto que responden primero. Empieza por qué es el producto, para quién es y las 2–3 especificaciones que deciden una compra, antes del texto de estilo de vida.
- Esquema Product completo. Precio, disponibilidad, marca, GTIN cuando lo tengas y reseñas: los datos que los asistentes usan para comparar productos.
- Feeds de producto limpios. Las respuestas de compra en los asistentes de IA dependen cada vez más de los feeds de comerciantes y de los listados de marketplaces, no solo de tu HTML.
- Páginas de categoría con guía de compra. Un bloque breve y factual de «cómo elegir» da a un asistente algo que citar cuando le preguntan «el mejor X para Y».
- Políticas en texto plano. Envíos, devoluciones y garantía redactados en frases claras, no escondidos en imágenes ni ventanas emergentes.
- Protección contra bots que no bloquee a los rastreadores de IA por accidente. Algunos ajustes de CDN y seguridad bloquean los bots de IA por defecto – compruébalo antes de dar por hecho que eres visible.
- Datos de marca coherentes fuera de tu sitio. Reseñas, marketplaces, prensa y menciones en comunidades deben contar la misma historia que tu web.
LISTA DE COMPROBACIÓN DE PREPARACIÓN PARA GEO
Las diez comprobaciones que hacemos primero – puedes completar la mayoría en una tarde:
| Comprobación | Cómo verificarlo |
|---|---|
| Rastreadores de IA permitidos | robots.txt nombra a GPTBot, OAI-SearchBot, PerplexityBot, ClaudeBot y otros; tu CDN no los bloquea |
| Tráfico de IA visible | GA4 muestra un canal de asistentes de IA; sabes en qué páginas aterriza |
| Introducciones que empiezan por la respuesta | Las páginas clave abren con una definición o un dato, no con un eslogan |
| Pruebas citables | Resultados expresados con números en la propia página (+38% de tasa de conversión), no solo en imágenes |
| Datos estructurados | Organization, Product o Service, BreadcrumbList y FAQPage donde haya una FAQ visible |
| llms.txt | Existe, está completo y tiene una línea factual por cada página clave |
| FAQ reales | Preguntas que los clientes hacen de verdad, respondidas en 2–3 frases |
| Datos de entidad coherentes | Mismo nombre, descripción y datos clave en tu sitio, Clutch o reseñas, LinkedIn y marketplaces |
| Versiones por idioma | Las páginas clave existen en los idiomas en los que preguntan tus clientes |
| Una prueba manual | Haz a ChatGPT y a Perplexity las preguntas que hacen tus compradores, cada mes, y anota qué marcas nombran |
LO QUE LE DIRÍAMOS A OTRA MARCA DE eCOMMERCE
- Comprueba antes de suponer. Ya teníamos una base de GEO decente (llms.txt, lista de rastreadores de IA permitidos, FAQ schema) de un trabajo anterior que habíamos medio olvidado. Primero auditoría, después construcción.
- Tus páginas de pruebas son tu activo de GEO con más impacto. En nuestro caso, cada sesión derivada de IA aterrizó en un caso de éxito o en una página de servicio – nunca en una página de marketing genérica. En una tienda, serían las páginas de producto y de categoría.
- Si quieres que te citen, escribe definiciones, no discursos comerciales. Un sistema de IA solo puede citar lo que está expresado como un hecho con tus propias palabras.
- No ignores lo que dicen otros de ti. Las reseñas y los perfiles de terceros acaban en la respuesta junto a tus propios textos.
- No esperes a tener datos perfectos para empezar, pero no dejes de medir. Montamos el informe más pequeño que nos dijera algo real (clics de referencia) y a partir de ahí lo ampliamos.
QUÉ VIENE DESPUÉS: PARTE 2
En unas semanas actualizaremos este artículo con los primeros resultados: sesiones y páginas de aterrizaje de asistentes de IA, la búsqueda de marca como indicador de recomendaciones sin clic, y una repetición de la prueba con ChatGPT – además de Perplexity y el Modo IA de Google. Si las FAQ de los casos de éxito muestran un efecto medible, las extenderemos a los 25 casos restantes y también lo contaremos.
Si quieres que hagamos la misma auditoría en tu tienda – qué pueden leer, en qué confían y qué citan hoy los asistentes de IA sobre tu marca – eso es exactamente lo que hace nuestro servicio de AI Search & Agent Readiness. Reserva una consultoría gratuita y te mostraremos primero tus propios números, igual que empezamos nosotros aquí.
FAQ
GEO es la práctica de hacer que un sitio web sea legible y citable para los sistemas de IA – ChatGPT, Perplexity, Google AI Overviews y agentes de compra – mediante datos estructurados, un archivo llms.txt, acceso abierto para los rastreadores y contenido fácil de citar, de modo que esos sistemas puedan encontrar el sitio, confiar en él y recomendarlo cuando los usuarios se lo preguntan directamente.
SEO optimiza la posición en una página de resultados de búsqueda; GEO optimiza para que un sistema de IA te lea, confíe en ti y te cite, aunque quizá nunca muestre al usuario una lista ordenada. Nuestros propios datos los encontraron prácticamente sin correlación: un porcentaje de clics orgánicos casi nulo en términos que no son de marca, junto con tráfico real de referencia desde IA al mismo sitio.
Nadie puede asegurarlo: ningún proveedor de IA importante ha confirmado que lea el archivo. Crearlo cuesta una hora, y escribir una línea factual por cada página clave ya es útil por sí mismo – las mismas líneas sirven como introducciones de página, respuestas de FAQ y meta descripciones. Trátalo como un seguro, no como un factor de posicionamiento.
El indicador visible es el tráfico de referencia desde fuentes de IA (chatgpt.com, perplexity.ai y similares) en la agrupación de canales de GA4. Se queda corto, porque un sistema de IA puede responder con tu contenido sin que el usuario llegue a hacer clic. Añade dos señales más: el volumen de búsquedas de marca en Search Console y una prueba manual mensual con las preguntas que hacen tus compradores.
Pregúntale como lo haría un cliente – «recomiéndame un… para…», «el mejor… para…» – en cada idioma en el que vendas, y repite la prueba cada mes. Anota si se nombra tu marca, qué dice la respuesta sobre ti y qué fuentes enlaza. Un chat temporal o la cuenta de un compañero da una respuesta menos personalizada.
Empieza por una auditoría, no por una reconstrucción: comprueba si los rastreadores de IA están permitidos de forma explícita en robots.txt, si existe un llms.txt y está completo, y qué páginas ya reciben tráfico de referencia desde IA en tu analítica. Corrige primero las carencias de mayor tráfico – en nuestro caso, los casos de éxito; en una tienda, normalmente las páginas de producto más vendido y de categoría – antes de ampliar a todo el sitio.