

Jak zoptymalizowaliśmy własną stronę pod wyszukiwanie AI: case study GEO
 Autor: Sergii Anufriiev, Założyciel i CEO — 05 paź 2026
Gdy zapytaliśmy ChatGPT o agencję do migracji na Shopify, wskazał URich jako pierwszy – po angielsku i po ukraińsku. W poprzednich 90 dniach Google przysłał nam dokładnie 2 kliknięcia z wyszukiwań spoza marki. Te dwa fakty leżą obok siebie w naszych danych i razem wyjaśniają, dlaczego przestaliśmy traktować wyszukiwanie AI jako „SEO pod nową nazwą”.
To część 1 naszego własnego case study GEO: punkt wyjścia, co sprawdziliśmy, co zmieniliśmy i pierwsze sygnały. Wyniki dodamy do tego artykułu, gdy będzie dość danych do porównania.
NAJWAŻNIEJSZE WNIOSKI
- Polecenia z AI i pozycje w Google to różne wskaźniki. W ciągu 30 dni z ChatGPT przyszło 14 sesji, a 11 548 wyświetleń w Google spoza marki dało 2 kliknięcia.
- Asystenci AI cytują fakty, a nie hasła. Przepisaliśmy wstępy stron usług na definicje, a każdemu case study dodaliśmy w
llms.txtjednolinijkowe podsumowanie poparte metryką. - Odpowiedzi AI powtarzają Twoje własne słowa. ChatGPT opisuje teraz naszą usługę migracji niemal tak samo jak nasze strony.
- Mierz to, co się da, i mów wprost o tym, czego się nie da. Kliknięcia z poleceń to dolna granica widoczności w AI, a nie górna.
DLACZEGO ZROBILIŚMY TO NA SOBIE
Sprzedajemy AI Search & Agent Readiness (GEO) jako usługę: audytujemy i poprawiamy to, jak sklepy eCommerce są odczytywane przez ChatGPT, Perplexity i AI Overviews. Gdy więc analityka pokazała realny, nieprowokowany ruch z ChatGPT, mieliśmy dwie opcje – napisać kolejny ogólnikowy poradnik „czym jest GEO” albo przeprowadzić audyt na sobie i opublikować dokładnie to, co znaleźliśmy, razem z liczbami. Wybraliśmy to drugie.
JAK ASYSTENCI AI DECYDUJĄ, KOGO CYTOWAĆ
Warto wiedzieć, pod co się optymalizuje. Asystent AI może znać Twoją markę na dwa sposoby:
- Z danych treningowych – migawki internetu zrobionej na miesiące przed Twoim pytaniem. Nie da się jej potem edytować.
- Z wyszukiwania na żywo – gdy ChatGPT search, Perplexity lub Google AI Overviews szukają informacji w chwili pytania, ich crawlery (OAI-SearchBot i ChatGPT-User, PerplexityBot, Googlebot) pobierają strony, model je streszcza i podaje linki do źródeł.
Na wyszukiwanie na żywo strona może wpływać. Żeby zostać zacytowana, strona musi być dostępna dla crawlera, łatwa do przetworzenia i zawierać zdanie, które model może wziąć jako fakt – definicję, liczbę, jasne „dla kogo to jest”. Fakty o marce muszą też być spójne w całym internecie: jeśli Twoja strona, profil na Clutch i strona na LinkedIn opisują Cię inaczej, model ma mniej powodów, by ufać któremukolwiek z nich.
Jedna uczciwa uwaga o llms.txt: to propozycja z 2024 roku, czyli tekstowa mapa strony napisana dla modeli językowych. Żaden duży dostawca AI nie potwierdził, że czyta ten plik, a przedstawiciele Google publicznie go zbagatelizowali. Traktujemy go jako tanie ubezpieczenie i przydatny bodziec do pisania jasnych streszczeń – a nie jako czynnik rankingowy.
KROK 1: SZUKAMY SYGNAŁU W DANYCH
GA4 już grupuje ruch w kanał „AI Assistant” – większość zespołów nigdy do niego nie zagląda, bo jest mały. W ostatnich 30 dniach było to 14 sesji, 100% z nich z chatgpt.com: prawdziwa osoba zadała ChatGPT pytanie, ChatGPT odpowiedział linkiem do naszej strony, a ona w niego kliknęła.
Strony docelowe pokazały, gdzie ChatGPT już uznawał nas za wartych cytowania: głównie case studies (/cases/aurora-crystal/, /cases/janado/, /cases/) i kilka stron usług (headless commerce, rozwiązania AI, rozwój na Shopify).
Zaskoczyły nas dwie rzeczy. Po pierwsze, ChatGPT już kierował ludzi na nasze ukraińskie strony – /uk/services/headless-e-commerce/ i /uk/services/shopify-development/ – w ciągu kilku tygodni od uruchomienia wersji ukraińskiej. Druga wersja językowa to druga szansa na dopasowanie do tego, jak ludzie naprawdę formułują pytania. Po drugie, trend szedł w dół: 14, potem 13, potem 10 sesji w kolejnych 30-dniowych oknach. Pozostawiona sama sobie, widoczność w AI nie rośnie.
KROK 2: DLACZEGO TO NIE TEN SAM WSKAŹNIK CO W SEO
Zanim cokolwiek zmieniliśmy, pobraliśmy 90 dni danych z Search Console jako punkt odniesienia. Zapytania markowe (zawierające „urich”) miały 1 892 wyświetleń i 36 kliknięć – typowy wzorzec wyszukiwań marki. Zapytania spoza marki miały 11 548 wyświetleń i zaledwie 2 kliknięcia – współczynnik klikalności 0,02%.
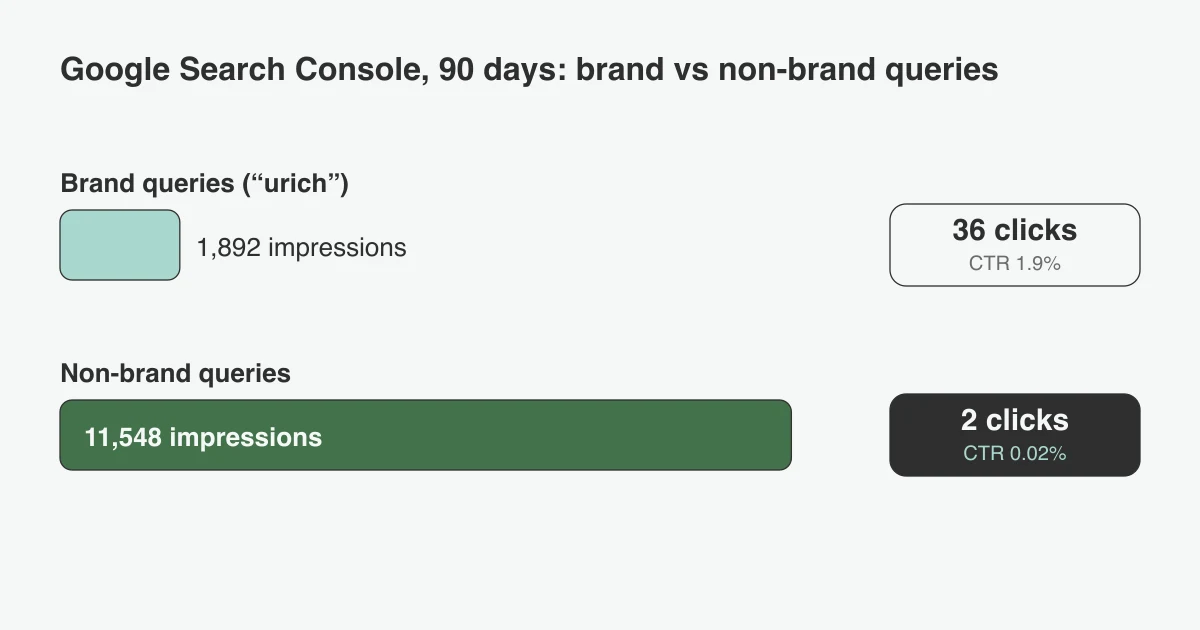
Mówiąc prosto: Google pokazuje nasze strony przy wielu zapytaniach long tail, ale prawie nikt nie klika, co zwykle oznacza niskie średnie pozycje dla tych fraz. Mimo to ChatGPT w tym samym czasie przysyłał nam prawdziwe kliknięcia. GEO i klasyczne SEO to sąsiednie dyscypliny, a nie ta sama – strona może być praktycznie niewidoczna w czołówce Google i nadal być cytowana przez asystenta AI, który przeczytał ją bezpośrednio.
Klasyczne SEO też nie stoi w miejscu: w ostatnim 28-dniowym oknie fraza „woocommerce to shopify migration” osiągnęła 588 wyświetleń przy średniej pozycji 18,9. Śledzimy jedno i drugie, osobno.
NIESPODZIEWANE ODKRYCIE: ŚLADY AI W SEARCH CONSOLE
Przeglądając zapytania long tail, znaleźliśmy wyszukiwania, których żaden człowiek nie wpisuje. Jedno brzmiało: „agent monetization, commercial, mofu, primary, ai/product teams, hero h1 directly references this concept” – fragment czegoś, co wygląda na brief treści. Inne: „accuracy of ai seo geo platforms tracking position in ai shopping guides”.
Nasza robocza hipoteza: narzędzia AI – agenci badawczy, platformy SEO, asystenci z wyszukiwaniem w sieci – wykonują wyszukiwania w Google w czyimś imieniu, a ich prompty czasem przeciekają do zapytania. Nie możemy udowodnić, kto je wysłał, więc traktuj to jako obserwację, a nie fakt. To jednak przydatne przypomnienie, że część Twojej „publiczności z wyszukiwarki” to już oprogramowanie, które czyta Twoje strony tak samo jak model.
KROK 3: AUDYT TEGO, CO JUŻ MIELIŚMY DOBRZE
Zanim cokolwiek dodaliśmy, sprawdziliśmy, co już było:
- llms.txt już istniał pod adresem
/llms.txt– tekstowy indeks naszych usług, realizacji i informacji o firmie, napisany dla systemów AI, a nie dla robotów wyszukiwarek. robots.txtjuż jawnie dopuszczał GPTBot, ChatGPT-User, OAI-SearchBot, PerplexityBot, ClaudeBot, Claude-User, Google-Extended, Applebot-Extended, Amazonbot i osiem kolejnych nazwanych crawlerów AI – a nie tylko domyślną regułę z wildcardem.- Dane strukturalne (JSON-LD) już obejmowały schematy Organization, WebSite, BreadcrumbList i Article w całym serwisie, a schemat FAQPage na 82 z 131 zaindeksowanych stron.
To solidny fundament – większość stron nie ma żadnego z tych elementów. Ale gdy sprawdziliśmy dane zamiast zakładać, wyszły dwie konkretne luki: llms.txt wymieniał tylko 3 z naszych 28 opublikowanych case studies, a większość stron usług zaczynała się od tekstu marketingowego („odblokuj nieograniczoną elastyczność…”), a nie od definicji, którą system AI mógłby wziąć i zacytować jako fakt.
KROK 4: ZAMYKAMY LUKĘ W CASE STUDIES
Dwóch case studies, które już przyciągały ruch z ChatGPT – Aurora Crystal i Janado – w ogóle nie było w llms.txt. Rozszerzyliśmy plik na wszystkie 28 opublikowanych realizacji, po jednej linijce na każdą, z prawdziwą, już opublikowaną metryką zamiast ogólnego opisu:
[Aurora Crystal](https://urich.org/cases/aurora-crystal/): dedykowany motyw Shopify dla luksusowej marki biżuterii, +26% konwersji na mobile.[Janado](https://urich.org/cases/janado/): skalowalny marketplace eCommerce, +38% współczynnika konwersji.
Logika: system AI odpowiadający na pytanie „kto zbudował sklep na Shopify dla luksusowej marki” albo „agencja eCommerce z case study z fintechu” potrzebuje konkretnego, cytowalnego faktu – a nie akapitu przymiotników.
KROK 5: PRZEPISUJEMY STRONY USŁUG JAKO DEFINICJE, NIE PREZENTACJE SPRZEDAŻOWE
Tekst marketingowy i tekst nadający się do cytowania czyta się inaczej. Nasza strona o headless commerce zaczynała się tak:
„Rozwój headless E-COMMERCE dla wydajnego, odpornego na przyszłość commerce. Odblokuj nieograniczoną elastyczność, skalowalność i szybkość dzięki headless eCommerce.”
Jako prezentacja sprzedażowa jest w porządku, ale system AI nie weźmie „odblokuj nieograniczoną elastyczność” jako faktu o tym, czym naprawdę jest headless commerce. Przepisaliśmy to najpierw jako definicję, a dopiero potem jako pozycjonowanie:
„Headless commerce oddziela witrynę sklepu (frontend) od platformy zaplecza (backend) i łączy je przez API zamiast jednego monolitycznego systemu. URich buduje headless witryny sklepów na Next.js/React, połączone z Shopify, BigCommerce, Commerce Layer lub w pełni dedykowanym backendem – zwykle dla marek D2C, które potrzebują czasów ładowania poniżej sekundy, pełnej kontroli nad designem albo skalowania na wiele regionów i walut ponad to, co daje standardowy motyw platformy.”
To samo zrobiliśmy ze wstępami naszych głównych stron usług.
Prosty test, który stosujemy teraz do każdego wstępu: czy to zdanie mogłoby pojawić się bez zmian w odpowiedzi na pytanie „czym jest X i kto to robi?” Jeśli ma sens tylko jako reklama, nikt go nie zacytuje.
KROK 6: FAQ TAM, GDZIE JUŻ BYŁ RUCH – NIE WSZĘDZIE NARAZ
Dodaliśmy widoczną sekcję FAQ (wraz z odpowiednim schematem FAQPage) do Aurora Crystal, Janado i Oroy – trzech case studies, które według GA4 już dostawały kliknięcia z AI – zamiast do wszystkich 28 naraz. Każde FAQ odpowiada na pytanie oparte na opublikowanych faktach danego projektu (np. „Dlaczego porzucanie checkoutu spadło o 34%?”), a nie na ogólnikowym szablonie. Ustalanie priorytetów na podstawie dowodów pozwoliło nam wdrożyć, zweryfikować i zmierzyć, zanim zajmiemy się pozostałymi 25.
KROK 7: MIERZYMY TO, CZEGO NIE WIDAĆ W PEŁNI
Ustawiliśmy stały tygodniowy raport (GA4 + Search Console) ze specjalną sekcją „Polecenia z AI Assistant” – które strony docelowe, które źródła AI i jaki jest trend w czasie. To niedoskonały zastępnik: chatbot może przeczytać nasze treści i odpowiedzieć na ich podstawie, a nikt nigdy nie kliknie, i żadne narzędzie analityczne tego nie pokaże. Kliknięcie z polecenia to dolna granica widoczności w AI, a nie górna – ale to część, którą naprawdę możemy dziś zmierzyć, więc ją śledzimy.
WCZESNY SYGNAŁ: CO CHATGPT MÓWI O NAS TERAZ
Po wdrożeniu zmian zadaliśmy ChatGPT pytanie, które zadałby potencjalny klient. Pytaliśmy z własnego konta, więc odpowiedź może być spersonalizowana – traktuj ją jako sygnał, a nie dowód.
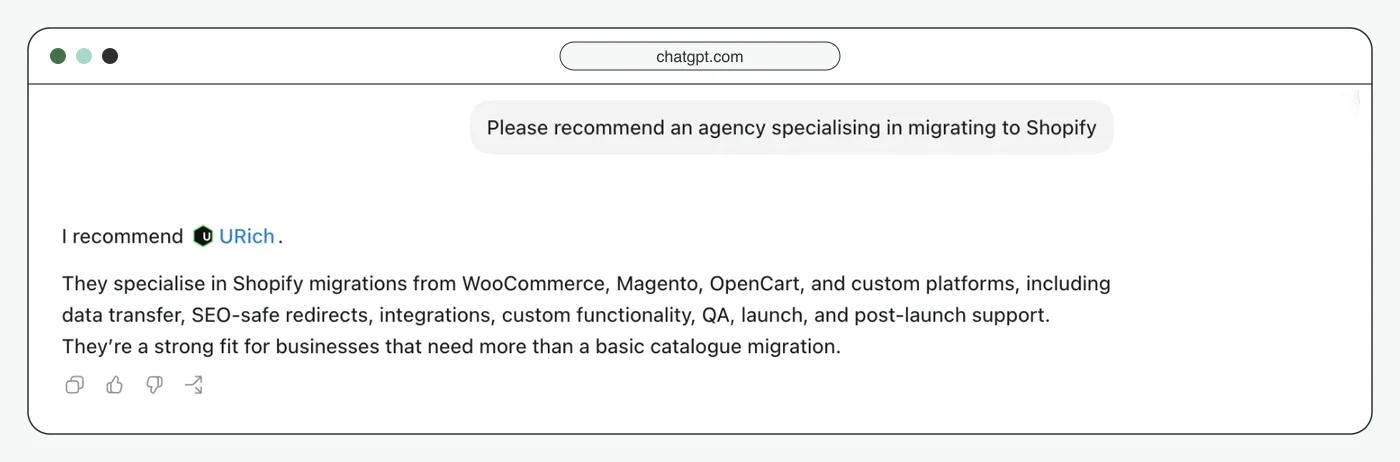
Co widzimy w tej odpowiedzi:
- Powtarza nasze własne sformułowania. „WooCommerce, Magento, OpenCart i platformy dedykowane… przekierowania bezpieczne dla SEO… wsparcie po starcie” jest bliskie temu, jak nasze strony o migracji opisują dziś tę usługę.
- Wyjaśnia, dla kogo jesteśmy. „Dobry wybór dla firm, które potrzebują czegoś więcej niż podstawowej migracji katalogu” – to pozycjonowanie, a nie tylko lista usług.
- Wskazuje jedną agencję, a nie listę. Odpowiedź poleca wyłącznie URich, bez krótkiej listy alternatyw.
Nie możemy przypisać tej odpowiedzi żadnej pojedynczej zmianie – może się opierać także na starszych danych. Właśnie dlatego w części 2 porównamy liczby, a nie zrzuty ekranu.
CZEGO JESZCZE NIE WIEMY
- Liczby są małe. 10–14 sesji miesięcznie może się wahać przez tydzień jednej osoby. Patrzymy na trendy w skali miesięcy, a nie dni.
- Odpowiedzi się różnią. To samo pytanie może jutro dać inną odpowiedź – z innego konta lub w innym kraju.
- Cytowania bez kliknięć są niewidoczne. Jeśli ChatGPT nas poleci, a użytkownik zapamięta nazwę zamiast kliknąć, analityka nic nie pokaże – co najwyżej późniejsze wyszukanie marki.
- Atrybucja jest niejasna. llms.txt, przepisane wstępy, FAQ i nasze opinie na zewnętrznych platformach zmieniły się lub istniały w tym samym czasie. Nie umiemy wskazać, które z nich ma największe znaczenie.
JAK TO PRZEŁOŻYĆ NA SKLEP INTERNETOWY
Nasza strona sprzedaje usługi, więc liczyły się case studies i strony usług. W sklepie eCommerce te same zasady dotyczą innych stron:
- Strony produktów, które odpowiadają najpierw. Zacznij od tego, czym jest produkt, dla kogo jest i 2–3 parametrów, które decydują o zakupie – przed tekstem o stylu życia.
- Kompletny schemat Product. Cena, dostępność, marka, GTIN tam, gdzie go masz, i opinie – fakty, których asystenci używają do porównywania produktów.
- Czyste feedy produktowe. Odpowiedzi zakupowe w asystentach AI coraz częściej opierają się na feedach sprzedawców i ofertach z marketplace’ów, a nie tylko na Twoim HTML-u.
- Strony kategorii z poradnikiem zakupowym. Krótki, rzeczowy blok „jak wybrać” daje asystentowi AI coś, co może zacytować przy pytaniach typu „najlepszy X do Y”.
- Polityki zapisane zwykłym tekstem. Dostawa, zwroty i gwarancja opisane jasnymi zdaniami, a nie ukryte w grafikach czy wyskakujących okienkach.
- Ochrona przed botami, która przypadkiem nie blokuje crawlerów AI. Część ustawień CDN i zabezpieczeń domyślnie blokuje boty AI – sprawdź to, zanim uznasz, że jesteś widoczny.
- Spójne informacje o marce poza twoją stroną. Opinie, marketplace’y, publikacje prasowe i wzmianki w społecznościach powinny opowiadać tę samą historię co twoja strona.
LISTA KONTROLNA GOTOWOŚCI NA GEO
Dziesięć kontroli, od których zaczynamy – większość zrobisz w jedno popołudnie:
| Kontrola | Jak zweryfikować |
|---|---|
| Crawlery AI mają dostęp | robots.txt wymienia GPTBot, OAI-SearchBot, PerplexityBot, ClaudeBot i inne; twój CDN ich nie blokuje |
| Widoczny ruch z AI | GA4 pokazuje kanał AI Assistant; wiesz, na jakie strony trafia ten ruch |
| Wstępy z odpowiedzią na początku | Kluczowe strony zaczynają się od definicji lub faktu, a nie od hasła |
| Dowody, które można zacytować | Wyniki podane liczbami w samej treści strony (+38% współczynnika konwersji), a nie tylko na grafikach |
| Dane strukturalne | Organization, Product lub Service, BreadcrumbList oraz FAQPage tam, gdzie jest widoczne FAQ |
| llms.txt | Plik istnieje, jest kompletny i ma jedną rzeczową linijkę dla każdej kluczowej strony |
| Prawdziwe FAQ | Pytania, które klienci naprawdę zadają, z odpowiedziami w 2–3 zdaniach |
| Spójne dane o marce | Ta sama nazwa, opis i kluczowe fakty na twojej stronie, w Clutch lub serwisach z opiniami, na LinkedIn i w marketplace’ach |
| Wersje językowe | Kluczowe strony istnieją w językach, w których pytają twoi klienci |
| Test ręczny | Co miesiąc zadaj ChatGPT i Perplexity pytania, które zadają twoi kupujący, i zanotuj, kto zostaje wymieniony |
CO POWIEDZIELIBYŚMY INNEJ MARCE ECOMMERCE
- Sprawdź, zanim cokolwiek założysz. Mieliśmy już solidne podstawy GEO (llms.txt, listę dozwolonych crawlerów AI, schemat FAQ) z wcześniejszych prac, o których częściowo zapomnieliśmy. Najpierw audyt, potem budowa.
- Strony z dowodami to twój najskuteczniejszy zasób GEO. U nas każda sesja z polecenia AI trafiała na case study lub stronę usługi – nigdy na ogólną stronę marketingową. W sklepie będą to strony produktów i kategorii.
- Jeśli chcesz być cytowany, pisz definicje, a nie oferty. System AI może zacytować tylko to, co jest podane jako fakt twoimi własnymi słowami.
- Nie ignoruj tego, co mówią o tobie inni. Opinie i profile w serwisach zewnętrznych trafiają do odpowiedzi obok twoich własnych treści.
- Nie czekaj na idealne dane, ale nie rezygnuj z mierzenia. Zbudowaliśmy najmniejszy raport, który powiedział nam coś realnego (kliknięcia z poleceń), a potem go rozbudowywaliśmy.
CO DALEJ: CZĘŚĆ 2
Za kilka tygodni zaktualizujemy ten artykuł o pierwsze wyniki: sesje z asystentów AI i strony docelowe, wyszukiwania marki jako wskaźnik rekomendacji bez kliknięć oraz powtórzony test ChatGPT – a także Perplexity i Google AI Mode. Jeśli FAQ w case study dadzą mierzalny efekt, wdrożymy je w pozostałych 25 realizacjach i też o tym napiszemy.
Jeśli chcesz, żebyśmy przeprowadzili taki sam audyt w twoim sklepie – co asystenci AI mogą dziś przeczytać, czemu ufają i co cytują na temat twojej marki – dokładnie to robi nasza usługa AI Search & Agent Readiness. Umów bezpłatną konsultację, a najpierw pokażemy ci twoje własne liczby, tak samo jak zaczęliśmy tutaj.
FAQ
GEO to działania, dzięki którym strona staje się czytelna i cytowalna dla systemów AI – ChatGPT, Perplexity, Google AI Overviews i agentów zakupowych – poprzez dane strukturalne, plik llms.txt, otwarty dostęp dla crawlerów i treści przyjazne cytowaniu. Dzięki temu systemy te mogą znaleźć stronę, jej zaufać i ją polecać, gdy użytkownicy pytają je wprost.
SEO optymalizuje pozycję na stronie wyników wyszukiwania; GEO optymalizuje to, by system AI przeczytał stronę, jej zaufał i ją zacytował – a taki system może w ogóle nie pokazać użytkownikowi listy rankingowej. Nasze dane pokazały, że te dwie rzeczy praktycznie ze sobą nie korelują: niemal zerowy organiczny CTR na frazy niemarkowe, przy realnym ruchu z poleceń AI na tę samą stronę.
Nikt nie wie na pewno: żaden duży dostawca AI nie potwierdził, że czyta ten plik. Jego przygotowanie zajmuje godzinę, a napisanie jednej rzeczowej linijki dla każdej kluczowej strony jest przydatne samo w sobie – te same linijki sprawdzą się jako wstępy stron, odpowiedzi w FAQ i meta opisy. Traktuj go jak ubezpieczenie, a nie czynnik rankingowy.
Widocznym wskaźnikiem zastępczym jest ruch z poleceń ze źródeł AI (chatgpt.com, perplexity.ai i podobnych) w grupowaniu kanałów GA4. Zaniża on realny wpływ, bo system AI może odpowiedzieć na podstawie twoich treści, a użytkownik nigdy nie kliknie w link. Dodaj dwa kolejne sygnały: wolumen wyszukiwań marki w Search Console oraz comiesięczny ręczny test pytań, które zadają twoi kupujący.
Pytaj tak, jak zapytałby klient – „poleć … do …”, „najlepszy … do …” – we wszystkich językach, w których sprzedajesz, i powtarzaj test co miesiąc. Zanotuj, czy twoja marka jest wymieniona, co odpowiedź o niej mówi i do jakich źródeł prowadzą linki. Czat tymczasowy lub konto współpracownika daje mniej spersonalizowaną odpowiedź.
Zacznij od audytu, a nie od przebudowy: sprawdź, czy crawlery AI są wprost dozwolone w robots.txt, czy plik llms.txt istnieje i jest kompletny oraz które strony już dostają ruch z poleceń AI w analityce. Najpierw uzupełnij luki na stronach z największym ruchem – u nas były to case study, w sklepie zwykle będą to bestsellerowe produkty i kategorie – a dopiero potem rozszerzaj działania na całą witrynę.